요약
⏱ 00:031. 도입: 나이브 베이즈는 질문 대신 센다
⏱ 00:03영상은 모델이 100% 확신하게 만든 잘못된 예측을 보여주며 시작한다. 같은 데이터에서 작은 수정 하나로 이 문제가 해결된다는 예고다. 나이브 베이즈는 결정 트리처럼 질문을 차례로 던지지 않고, 각 답이 얼마나 흔한지와 주어진 증거가 그 답에 얼마나 잘 맞는지를 세어 두 가지를 결합한다. 이 결합 규칙이 베이즈 정리다.

⏱ 00:502. 베이즈 정리: 사전확률과 우도
⏱ 00:50베이즈 정리는 증거가 주어졌을 때 어떤 결과의 확률이 사전확률과 우도의 곱에 비례한다는 내용이다. 사전확률은 개인 정보를 보기 전에 그 결과가 얼마나 흔한지에 대한 믿음이고, 우도는 증거가 그 결과 집단에서 얼마나 자주 나타나는지다. 결과가 여러 개면 각각 계산한 뒤 합이 100%가 되도록 비율을 맞춘다.

예시에서는 당뇨가 있는 사람과 없는 사람이 각각 6명씩이라 사전확률이 0.5로 같다. 즉 개인 정보를 보기 전에는 50대 50이다.
⏱ 01:353. 범주형 특성은 빈도, 수치형은 종 모양 곡선
⏱ 01:35각 집단 안에서 특성별로 센다. 가족력은 당뇨 집단 6명 중 5명이 가지고 있고, 비당뇨 집단에서는 0명이다. 운동 습관은 당뇨 집단에서 2명, 비당뇨 집단에서 5명이 규칙적으로 한다. 이렇게 얻은 비율이 우도다.

BMI처럼 연속된 수치는 예/아니오로 셀 수 없으므로 각 집단의 평균과 표준편차로 정규분포 곡선을 그린다. 당뇨 집단의 평균 BMI는 30.17, 비당뇨 집단은 26이다. BMI가 29일 때 곡선의 높이는 당뇨 쪽 0.0795, 비당뇨 쪽 0.0705로 나와 당뇨 쪽이 약간 더 잘 맞는다고 해석한다.
⏱ 02:514. 나이브 가정과 예측 계산
⏱ 02:51여러 특성의 우도를 하나로 합칠 때 나이브 베이즈는 단순히 곱한다. 이는 같은 집단 안에서 특성들이 서로 영향을 주지 않는다는 가정이 있을 때만 정확하다. 실제로는 대개 그렇지 않아서, 영상에서도 당뇨 집단 내 가족력과 운동이 서로 연관되어 있다고 짚는다. 가정이 틀렸다는 것을 알면서도 쓰는 이유는 모델이 매우 단순하고 빠르며, 최종 판단에는 두 점수 중 큰 쪽만 필요하기 때문이다.

가족력이 없고 운동을 하지 않으며 BMI가 29인 사람에게 적용하면 당뇨 쪽 점수는 0.00442, 비당뇨 쪽 점수는 0.00587이 나온다. 이를 합이 1이 되도록 맞추면 당뇨 43%, 비당뇨 57%다. 같은 사람에 대해 결정 트리는 당뇨라고 답했으므로, 두 모델이 경계선 사례에서 다른 결론을 낼 수 있음을 보여준다.
⏱ 04:295. 0 확률 함정과 라플라스 스무딩
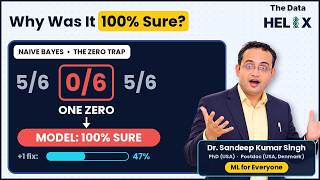
⏱ 04:29가족력이 있고 규칙적으로 운동하며 BMI가 21인 테스트 대상자를 보자. 비당뇨 집단에서 가족력 우도가 0이므로 곱셈 전체가 0이 되고, 모델은 운동과 BMI라는 다른 증거를 모두 무시한 채 당뇨 100%라고 답한다. 우연히 비당뇨 집단에 가족력 있는 사람이 없었을 뿐인데 한 번의 0이 모든 정보를 지워 버리는 셈이다.

해결책은 라플라스 스무딩이다. 모든 개수에 1을 더하고 분모에 2를 더한다. 5/6은 6/8이 되고, 0/6은 1/8이 된다. 이렇게 하면 어떤 확률도 정확히 0이 되지 않으며, 이 사람의 결과는 당뇨 47%로 과신하지 않는 답이 된다.
⏱ 05:406. 성능 비교, 활용 분야와 정리
⏱ 05:4012명 데이터에서 한 명을 숨기고 나머지 11명으로 학습해 맞히는 검증에서 스무딩을 적용한 나이브 베이즈는 9명을 맞혔고, 결정 트리는 10명을 맞혔다. 특성이 3개뿐인 작은 데이터에서는 트리가 낫지만, 나이브 베이즈는 스팸 필터나 텍스트 분류처럼 특성이 수천 개인 데이터에서 빠르게 학습되어 좋은 첫 기준 모델로 자주 쓰인다.

정리하면 사전확률은 각 답의 흔함이고, 우도는 범주형은 빈도로, 수치형은 종 모양 곡선으로 계산한다. 이를 곱한 뒤 100%로 맞추며, 항상 스무딩으로 0 하나가 전체를 지우지 않도록 한다. 영상은 스무딩을 적용한 새 사람의 계산을 직접 해 보는 연습 문제로 마무리한다.