요약
⏱ 00:001. 사례와 시험 도메인 개요
⏱ 00:00같은 자격 요건을 갖춘 두 지원자의 이력서 중 하나는 승인되고 하나는 거절되는 사례로 강의는 시작한다. SageMaker Clarify로 살펴보니 원인은 경력이나 기술이 아니라 출신 학교였고, 강의는 이를 편향이 드러난 사례로 소개한다. 이 내용은 AIFC01 시험의 네 번째 도메인으로 전체 점수의 14%를 차지하며, 실습보다 시나리오를 읽고 적합한 원칙이나 도구를 고르는 개념 중심 문제로 출제된다.

⏱ 02:182. 공정성과 편향의 출처
⏱ 02:18공정성은 결과가 같아야 한다는 뜻이 아니라 동등한 대우를 받는다는 뜻이다. 자격이 같은 지원자는 소속 집단과 관계없이 같은 기회를 얻어야 하며, 결과 차이가 자격 요건에서 왔다면 공정하지만 집단 때문이라면 편향이다. 시험의 핵심 질문은 결과를 바꾼 것이 집단인지 자격 요건인지를 구분하는 것이다.

⏱ 03:463. Clarify로 측정하고 SHAP으로 설명하기
⏱ 03:46SageMaker Clarify는 두 시점에서 편향을 측정한다. 사전 훈련 지표는 모델을 만들기 전 데이터에서 집단 간 비율 차이, 즉 클래스 불균형을 보고, 사후 훈련 지표는 예측 결과에서 집단별 승인 비율 차이를 본다. 예시에서는 한 집단이 이력서의 80%를 차지해 데이터가 이미 기울어 있었고, 사후에는 승인 격차가 31포인트로 벌어져 모델이 편향을 키운 것으로 나타났다.

측정이 일의 절반이라면 결정을 설명하는 것이 나머지 절반이다. SHAP 값은 개별 예측마다 각 특성이 결정에 얼마나 기여했는지 보여 주며, 이 사례에서는 거절의 가장 큰 요인이 학교로 밝혀졌다. 설명 가능성은 거절된 지원자가 이유를 알고 항의할 수 있게 하고, 팀이 편향을 발견해 고치는 데 필수적이다.
⏱ 05:434. 개인 정보 보호와 투명성 문서화
⏱ 05:43개인 정보 보호는 더 적게 가져가는 데서 출발한다. 데이터 최소화는 업무에 필요한 데이터만 수집하는 것이며, '혹시 몰라서' 모으는 데이터는 노출 위험을 키운다. 개인 정보로 학습된 모델은 답변 과정에서 이를 유출할 수 있으므로, 최소화는 인색함이 아니라 통제라고 강조한다.

⏱ 06:395. 가드레일과 레드 팀
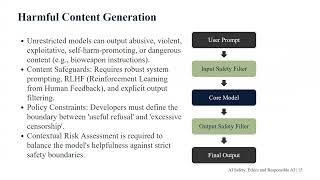
⏱ 06:39안전성은 희망이 아니라 가이드라인으로 확보한다. Amazon Bedrock의 Guardrails는 사용자와 모델 사이에서 모든 요청과 응답에 정책을 적용한다. 금지된 주제를 차단하고, 혐오, 폭력, 학대 콘텐츠를 걸러내며, PII 필터로 입력과 출력의 개인 정보를 마스킹한다. 모델 자체를 더 좋게 만들지는 않지만 나쁜 출력이 사용자에게 보이기 전에 막는다.

가드레일은 예상한 것만 걸러낼 수 있으므로 나머지는 레드 팀이 맡는다. 레드 팀은 실제 공격자가 나타나기 전에 허가받은 테스터가 탈옥, 프롬프트 주입, 유해한 출력 유도 같은 공격을 시도해 취약점을 찾는 적대적 테스트다. 발견된 취약점을 개발자가 고친 뒤 시스템을 출시하며, 다른 사람이 찾기 전에 고의로 취약점을 찾는 것이 핵심이다.
⏱ 07:326. 제어 가능성, 정확성, 거버넌스, 모니터링
⏱ 07:32제어 가능성은 위험도에 따라 사람의 개입 수준을 정하는 문제다. 영화 추천은 자동 승인해도 괜찮지만, 채용, 대출, 의료 분류는 잘못된 거절이 생계를 위협하고 잘못된 분류가 생명을 앗아갈 수 있다. 따라서 이런 고위험 영역에서는 모델이 조언하고 사람이 결정해야 한다. 정확성은 답변이 사실에 기반해 검증을 견디는 것이며, 근거 없이 자신만만한 환각은 정확성 실패다. 견고성은 같은 질문에 오타나 이상한 문구, 예외 상황이 섞여도 답변이 안정적으로 유지되는 것이다.

거버넌스는 소유자를 지정하고 구축할 수 있는 것과 없는 것을 정하는 정책 영역이며, 문제가 생겼을 때 답할 책임자와 사후 검토가 가능한 감사 추적을 포함한다. 공정성은 출시 시점에 한 번 확인하고 끝내는 체크 박스가 아니다. 지원자 구성이나 패턴이 바뀌면 격차가 생기므로 Clarify를 다시 실행해 지표를 재확인하는 모니터링이 필요하다.
⏱ 10:037. 예시 문제와 핵심 정리
⏱ 10:03강의는 두 가지 예시로 적용을 연습한다. 첫째, 소득이 같아도 특정 지역 지원자를 덜 승인하는 대출 모델의 격차를 측정하고 원인을 찾아야 한다면 정답은 Amazon Comprehend가 아니라 SageMaker Clarify다. Comprehend는 텍스트, 감정, 개체, 언어를 분석할 뿐 편향을 측정하지 않는다. 둘째, 서비스를 도입하기 전 한계와 사용하지 말아야 할 경우를 확인하려면 AI 서비스 카드가 정답이다. CloudTrail은 누가 어떤 API를 호출했는지 기록할 뿐 한계를 알려 주지 않는다.

핵심 정리로, 공정성은 Clarify로 측정하고 결정은 SHAP으로 설명하며 한계는 서비스 카드로 문서화한다. 이미지 출처는 Titan의 워터마크로 증명하고 잘못된 출력은 Guardrails로 차단하며 취약점은 레드 팀이 먼저 공격해 찾게 한다. 무엇보다 위험이 큰 상황에서는 사람이 결정한다는 규칙을 기억해야 한다. 다음 챕터는 AI 솔루션의 보안, 규정 준수, 거버넌스와 공동 책임을 다룬다고 소개하며 마무리한다.