요약
⏱ 02:32MDP는 상태 S, 행동 A, 전이 확률 P, 할인율 γ, 보상 R로 정의된다. 정책 π는 현재 상태에서 취할 행동을 정하며, 목표는 할인 보상 합의 기댓값을 최대화하는 것이다. 예제 로봇은 의도한 방향으로 80%, 좌우로 각각 10% 확률로 이동한다. 상태가 11개이고 행동이 네 개이면 정책이 4¹¹개이므로 모든 정책을 직접 비교하는 대신 가치함수를 활용한다.
⏱ 06:48정책 π의 가치함수 V^π(s)는 s에서 출발해 π를 실행할 때의 기대 총수익이다. 벨만 방정식 V^π(s)=R(s)+γ∑P_{s,π(s)}(s′)V^π(s′)는 즉시 보상과 다음 상태 이후의 보상을 분리한다. 정책이 고정되면 상태별 가치를 미지수로 하는 선형 연립방정식으로 풀 수 있다. 최적 가치 V*(s)=max_πV^π(s)는 가능한 최고 수익이며, 최적 벨만 방정식에서는 행동에 대한 최댓값을 취한다.
⏱ 36:19가치 반복은 모든 V(s)를 0으로 시작해 최적 벨만 식을 반복 적용한다. 오차는 할인율에 따라 기하급수적으로 줄어든다. 모든 이전 값으로 새 벡터를 계산하는 동기 갱신과 값을 하나씩 즉시 바꾸는 비동기 갱신 모두 가능하다. V*를 구하면 ∑P_{sa}(s′)V*(s′)를 최대화하는 행동을 골라 최적 정책을 얻는다. 예제에서는 서쪽의 기대 미래 가치 0.740이 북쪽의 0.676보다 높지만, 최종 선택에는 네 방향을 모두 비교해야 한다.
⏱ 50:44정책 반복은 무작위 정책에서 시작해 정책 평가와 정책 개선을 번갈아 수행한다. 현재 정책의 가치함수를 연립방정식으로 구하고, 그 가치를 기준으로 행동을 다시 선택한다. 유한 횟수 뒤 정책이 바뀌지 않으면 최적 정책에 도달한다. 작은 상태 공간에서는 빠를 수 있지만, 상태가 1만 개나 100만 개라면 선형계 풀이가 비싸져 가치 반복이 더 자주 쓰인다. 가치 반복의 점근적 수렴과 정책 반복의 유한 단계 종료를 구분해야 한다.
⏱ 00:031. 자율 로봇과 마르코프 결정 과정 복습

⏱ 00:03다시 만나 반갑습니다. 추수감사절은 잘 보냈나요? 이 의자가 왜 여기 있는지 모르겠네요. 치우겠습니다. 아난드, 고마워요. 여러분이 뉴스를 보고 있는지 모르겠지만, 강화학습에서는 로봇공학 이야기를 많이 합니다. 사람들이 강화학습으로 해결하려는 대표적인 문제 가운데 하나가 로봇 제어입니다. 지난 5월 이곳 캘리포니아에서 발사된 인사이트(InSight) 화성 착륙선이 앞으로 약 두 시간 반 뒤에 화성 착륙을 시도할 예정입니다. 저는 이 소식에 무척 기대하고 있습니다.
⏱ 00:41이것은 로봇공학의 가장 웅대한 응용 가운데 하나라고 생각합니다. 지구에서 화성까지 빛이 가는 데 약 20분이 걸리기 때문에 착륙이 시작되고 나면 지구에 있는 누구도 개입할 수 없습니다. 그래서 자율 로봇공학의 가장 흥미로운 응용 중 하나입니다. 우주선은 현재 지구에서 약 20광분 떨어져 있으므로 실시간으로 조종할 수 없습니다. 소프트웨어가 제대로 작동해 그 행성에 무사히 착륙하기를 간절히 바라야 합니다. 정오가 조금 지나면 성공 여부를 알게 될 겁니다. 저는 이런 일에 설레는데 여러분도 그랬으면 좋겠습니다. 캘리포니아 출신이라면 고향에서 발사된 우주선이 이제 화성 착륙을 앞두고 있다는 사실을 자랑스러워해도 좋겠지요.
⏱ 01:32오늘은 강화학습 논의를 이어가겠습니다. 먼저 MDP, 즉 마르코프 결정 과정(Markov decision process) 틀을 짧게 복습하고, MDP를 푸는 알고리즘을 다룹니다. 특히 각 상태에 있는 것이 얼마나 좋은지를 알려 주는 가치함수(value function)를 정의해야 합니다. 이어 가치함수를 계산하는 가치 반복(value iteration)을 살펴보고, 이를 이용해 MDP에 적합한 제어기, 즉 정책을 찾겠습니다. 마지막으로 상태 전이 확률을 학습하는 방법과 이 모든 요소를 결합해 실제로 구현할 수 있는 강화학습 알고리즘을 구성하는 방법까지 설명하겠습니다.
⏱ 02:24추수감사절 전에 계속 사용했던 예는 상태가 11개인 MDP였습니다. MDP는 상태 집합 S, 행동 집합 A, 상태 전이 확률 P, 할인율 γ, 보상함수 R이라는 다섯 요소의 튜플로 이루어집니다. 이 예에서는 상태가 11개이고, 행동은 북·남·동·서의 네 방향으로 이동을 시도하는 것입니다. 로봇이 북쪽으로 가려고 하면 0.8, 즉 80%의 확률로 북쪽에 가고, 각각 0.1, 즉 10%의 확률로 왼쪽이나 오른쪽으로 빗나갑니다. 할인율 γ는 보통 1보다 조금 작은 수로, 0.99라고 생각하면 됩니다. 보상함수 R은 로봇이 어디에 도달하기를 원하는지를 지정하는 데 사용합니다.
⏱ 03:26MDP에서는 먼저 어떤 상태 s₀에서 시작합니다. 이 펜이 훨씬 낫네요. 행동 a₀를 선택하면 전이 분포 P_{s₀a₀}에 따라 새로운 상태 s₁이 정해집니다. 이어 행동 a₁을 고르면 P_{s₁a₁}에 따라 그다음 상태로 이동합니다. 총수익은 할인된 보상들의 합입니다. 형식적으로 우리의 목표는 상태를 행동에 대응시키는 함수인 정책 π를 구하는 것입니다. 어느 상태에 있든 어떤 행동을 선택해야 하는지 알려 주면서, 총수익의 기댓값을 최대화하는 정책을 찾는 것이지요.
⏱ 04:282. 정책의 수와 정책 가치함수
⏱ 04:28지난 시간에는 여기 표시한 정책이 이 MDP의 최적 정책이라고 주장했습니다. 예를 들어 π(3,1)=서쪽입니다. 왼쪽이라고 써도 되고 왼쪽 화살표로 나타내도 됩니다. 상태 (3,1)에서는 서쪽으로 가는 것이 가장 좋은 행동이라는 뜻입니다. 정책을 실행한다는 것은 매 단계에서 현재 상태에 π를 적용해 나온 행동을 고른다는 의미입니다. 이제 가치함수를 정의해 보겠습니다. 제가 이 정책을 어떻게 구했을까요? 여러분이 MDP의 다섯 요소를 주어졌을 때 최적 정책을 계산하는 방법을 배우도록 하려는 것입니다.
⏱ 05:37최적 정책을 찾는 데 따르는 어려움은 가능한 정책의 수가 지수적으로 많다는 것입니다. 상태가 11개이고 각 상태에서 행동이 네 개라면 정책은 4¹¹개입니다. 이 수가 그리 크지 않은 이유는 상태가 11개인 MDP가 작기 때문입니다. 일반적으로 정책의 수는 행동 수를 상태 수만큼 거듭제곱한 |A|^{|S|}이므로 조합적으로 매우 커집니다. 이 가운데 가장 좋은 정책을 어떻게 찾을까요? 그것이 오늘 배울 내용입니다. 알고리즘을 개발하려면 V^π, V*, π*라는 세 가지를 정의해야 합니다. 이 정의들을 바탕으로 π*가 최적 정책임을 도출하겠습니다.
⏱ 06:46먼저 정책 π에 대해 V^π는 상태를 실수에 대응시키는 함수입니다. V^π(s)는 상태 s에서 시작해서 π를 실행할 때 얻는 총수익의 기댓값입니다. 이를 V^π(s)=E[총수익 | 정책 π 실행, s₀=s]라고 쓰기도 합니다. 이것을 정책 π의 가치함수라고 부릅니다. 로봇이 시작할 수 있는 각각의 상태에 대해, 그 상태에서 출발해 정책 π에 따라 행동할 경우 기대되는 총수익을 알려 주는 함수입니다. 정책을 실행한다는 말은 바로 그 정책이 지정하는 행동을 선택한다는 뜻입니다.
⏱ 08:38구체적인 정책 π 하나를 보겠습니다. 이것은 그다지 좋은 정책이 아닙니다. 일부 상태에서 보상 −1인 곳으로 향하기 때문입니다. 반대쪽 목적지에서 받는 보상은 +1이라는 점도 짚고 넘어가겠습니다. 이 두 곳은 흡수 상태(absorbing state)입니다. +1이나 −1에 한 번 도달하면 그 세계가 끝나고 이후에는 보상도 벌점도 없습니다. 정책은 상태를 행동으로 대응시키는 어떤 함수든 될 수 있으므로 꼭 좋은 정책일 필요는 없습니다. 여기의 상태 (4,1)에서는 북쪽으로 가라고 지시하는데, 그러면 −1 보상으로 가게 되므로 나쁜 행동입니다. 그래도 이것 역시 하나의 정책입니다.
⏱ 09:433. 가치의 수치 예와 벨만 방정식의 직관
⏱ 09:43이 정책의 가치함수 V^π는 여기 보이는 것과 같습니다. 지금은 개별 숫자에 너무 신경 쓰지 않아도 됩니다. 정책을 살펴보면 한쪽 상태 집합에서는 나쁜 보상으로 상당히 효율적으로 이동하고, 다른 쪽 집합에서는 좋은 보상으로 꽤 효율적으로 이동합니다. 다만 로봇이 잡음 때문에 옆으로 빗나가므로 두 결과가 어느 정도 섞입니다. 그래서 이쪽 영역의 수치는 모두 음수이고, 저쪽 영역의 수치는 적어도 어느 정도 양수입니다. 상태별 가치의 부호가 그 정책이 주로 어디로 로봇을 이끄는지를 반영하는 것입니다.
⏱ 10:41예를 들어 상태 (1,1)에서 시작한다면 할인된 보상 합의 기댓값은 −0.88입니다. 이것이 V^π가 뜻하는 바입니다. 이제 가치함수가 만족하는 식을 보겠습니다. 이를 벨만 방정식(Bellman's equation)이라고 부릅니다. 이 식은 어떤 상태에서의 기대 수익이 그 상태에서 받는 보상에 할인율을 곱한 미래 기대 보상을 더한 것이라고 말합니다. 이 관계가 왜 성립하는지 직관부터 설명하겠습니다. 초기 상태가 s₀라고 하고, 현재 상태를 나타내는 s가 s₀와 같다고 놓아 보세요.
⏱ 12:12로봇은 단지 상태 s에서 깨어났다는 이유만으로 즉시 R(s₀)를 받습니다. 나머지 항은 잠시 뒤에 더하겠습니다. 이것을 즉시 보상(immediate reward)이라고 부릅니다. 그 상태에서 출발한 것이 행운이든 불운이든, 로봇은 그에 해당하는 보상을 바로 받는 것이지요. 그런 다음 행동을 취해 새로운 상태 s₁에 도달하면 γR(s₁)이 할인된 보상에 기여합니다. 그다음 단계에서도 미래 보상을 받고 이 과정이 이어집니다. 따라서 정의를 완전히 쓰면 V^π(s)=E[R(s₀)+γR(s₁)+γ²R(s₂)+⋯ | π 실행, s₀=s]입니다.
⏱ 13:28이제 식의 뒤쪽을 조금 바꾸겠습니다. 미래 보상 부분 전체에서 γ 하나를 공통인수로 묶는 것입니다. 괄호를 사용하면 γR(s₁)+γ²R(s₂)+⋯=γ[R(s₁)+γR(s₂)+⋯]가 됩니다. 원래 γ²이던 항이 괄호 안에서는 γ가 되는 것은 밖으로 뺀 γ 하나가 나머지 인수를 제공하기 때문입니다. 이해되나요? 아니라면 다시 보세요. 제가 한 일은 나머지 식 전체에서 γ 하나를 묶어 낸 것뿐입니다. 따라서 상태 s의 가치는 즉시 보상에 미래 보상 기댓값의 γ배를 더한 것으로 쓸 수 있습니다.
⏱ 14:304. 미래 보상과 다음 상태의 표기

⏱ 14:30R(s₁)부터 시작하는 괄호 안 식의 기댓값은 V^π(s₁)입니다. 이 두 번째 항이 미래 보상의 기댓값에 해당합니다. 벨만 방정식은 로봇이 상태 s에서 깨어날 때 얻는 총수익의 기댓값이 즉시 보상에 미래 기대 보상의 γ배를 더한 것이라고 말합니다. 중괄호 위에 있는 부분은 로봇이 상태 s₁에서 깨어나 정책 π를 실행하면 얼마나 얻겠느냐는 질문입니다. 그때는 행동을 취해 s₂로 가고, 다시 행동해 s₃로 가며 계속 진행합니다. 그 보상들은 s₁을 출발점으로 삼아 할인합니다.
⏱ 15:53이렇게 해서 벨만 방정식이 성립하는 이유를 설명할 수 있습니다. 칠판 위쪽 식과 아래쪽 식의 표기가 어떻게 대응하는지도 보겠습니다. s는 s₀에, s′는 s₁에 해당합니다. 현재 상태의 가치는 R(s)에 다음 상태 s′의 할인된 기대 가치를 더한 것입니다. MDP의 긴 상태열을 쓸 때는 보통 s₀, s₁, s₂, s₃, s₄ 등으로 표시합니다. 반면 현재 상태와 한 시간 단계 뒤의 상태만 살펴볼 때는 s와 s′를 사용하는 편입니다. 그래서 두 식 사이에 이러한 표기 대응이 생깁니다.
⏱ 17:36그렇다면 s′는 어떤 분포에서 뽑을까요? s′ 또는 s₁은 한 단계 뒤에 도달하는 상태입니다. P의 아래첨자에 무엇이 들어갈까요? 학생이 “s”라고 답합니다. 맞습니다. s 다음에는요? “π(s)”입니다. 그렇지요. 정책 π를 실행하고 있으므로 상태 s에서 취하는 행동은 a=π(s)입니다. 정책이 바로 그 상태에서 이 행동을 하라고 알려 주기 때문입니다. 따라서 s′는 a=π(s)인 P_{sa}, 즉 P_{s,π(s)}에서 추출됩니다. 이제 이해되나요? 이 펜은 정말 자국이 선명하게 남네요.
⏱ 19:08모두 합치면 벨만 방정식은 V^π(s)=R(s)+γ E_{s′∼P_{s,π(s)}}[V^π(s′)]입니다. 기댓값을 합으로 풀어 쓰면 ∑_{s′}P_{s,π(s)}(s′)V^π(s′)가 됩니다. 여기 밑줄 친 항이 바로 그 기댓값입니다. 이 식으로 가치함수를 구하기 위한 선형 연립방정식을 얻을 수 있다는 점에 주목하세요. 좋은 정책이든 나쁜 정책이든 π 하나를 주고 V^π(s)를 구하려고 한다고 합시다. π는 주어진 것으로 두고 각 상태의 가치 V^π(s)를 미지수로 보면, 이 벨만 방정식들이 선형 연립방정식을 이룹니다.
⏱ 20:325. 선형 연립방정식으로 정책 평가하기
⏱ 20:32우리가 구할 미지수는 각 상태의 V^π(s)입니다. 구체적인 예로 상태 (3,1)을 보겠습니다. 벨만 방정식에 따르면 V^π(3,1)은 (3,1)에서의 즉시 보상에, 가능한 다음 상태들의 전이 확률과 가치를 곱해 합한 값의 γ배를 더한 것입니다. π(3,1)이 북쪽이라고 합시다. 이 상태에서 북쪽으로 가려고 하면 확률 0.8로 (3,2)에 도달하고, 확률 0.1로 왼쪽으로, 확률 0.1로 오른쪽으로 빗나갑니다. 여기서 괄호를 닫으면 됩니다. 이것이 벨만 방정식이 이 상태 가치들 사이에 부과하는 관계입니다.
⏱ 22:01가치함수를 구하려 한다면 제가 보라색으로 동그라미 치고 있는 항들이 미지수입니다. 이 MDP에는 상태가 11개 있으므로 미지수 11개에 대한 선형 방정식 11개를 얻습니다. 선형대수 풀이기를 사용하면 이 11개 값을 명시적으로 구할 수 있습니다. 이해되나요? 어떤 정책 π든 하나를 주면, V^π(1,1), V^π(1,2) 등에서 마지막 상태 (4,3)의 값까지 담는 11차원 벡터를 만듭니다. 바로 그 벡터의 11개 성분이 우리가 구하려는 미지의 상태 가치들입니다.
⏱ 23:3011개 상태 각각을 벨만 방정식의 왼쪽에 대입하세요. 그러면 벡터의 한 성분이 다른 몇몇 성분의 선형 결합과 보상으로 어떻게 정해지는지를 나타내는 식 하나씩이 나옵니다. 따라서 미지수 11개에 대한 방정식 11개를 구성하고 선형대수 풀이기로 풀면 됩니다. 이 방법은 이산적인 상태에 대해 적용됩니다. 상태가 11개라면 컴퓨터가 방정식 11개를 푸는 데는 거의 시간이 들지 않습니다. 실제로 V^π를 구하라는 요청을 받으면 제가 보여 준 값들을 이렇게 계산하는 것입니다. 방금 설명이 이해되었나요? 이해한 사람은 손을 들어 보세요. 좋습니다.
⏱ 24:496. 최적 가치함수와 최적 벨만 방정식
⏱ 24:49V^π를 정의했으니 이제 V*를 정의하겠습니다. V*는 최적 가치함수이며 V*(s)=max_π V^π(s)입니다. 강화학습 용어가 조금 혼란스러울 수 있는 이유는 두 가지를 모두 가치함수라고 부르기 때문입니다. 하나는 특정 정책 π의 가치함수로, 그 정책은 훌륭할 수도, 형편없을 수도, 최적일 수도 있습니다. 다른 하나는 처음부터 최적 가치함수인 V*입니다. V*를 정의할 때는 이 예의 4¹¹개처럼 가능한 모든 정책을 살펴보고, 해당 상태에서 그중 가장 좋은 정책이 달성하는 값을 택합니다.
⏱ 26:40V*에 대해서는 또 다른 형태의 벨만 방정식이 있습니다. 가치함수가 두 종류인 것처럼 벨만 방정식도 특정 정책에 대한 식과 최적 가치함수에 대한 식의 두 가지가 있는 것입니다. 로봇이 상태 s에서 시작할 때 가능한 최고의 할인 보상 합 기댓값이 무엇인지 생각해 보세요. 로봇은 그곳에서 깨어난 것만으로 R(s)를 받습니다. 그런 다음 어떤 행동을 취하고 다른 상태 s′에 도달합니다. 거기서부터 얻을 수 있는 최고의 미래 기대 수익은 V*(s′)이고, 이 값에는 γ를 곱해 할인해야 합니다.
⏱ 28:07다음 상태 s′는 처음 상태에서 행동 a를 취한 결과로 도달한 곳입니다. 상태 s에서 a를 선택하면 s′는 P_{sa}에서 정해지고, 기대 수익은 즉시 보상에 미래 기대 수익의 γ배를 더한 값입니다. 그렇다면 여기에 어떤 행동 a를 넣어야 할까요? 최적 행동은 총수익의 기댓값, 즉 보상 합의 기댓값을 최대화하는 행동입니다. 따라서 그 식을 가장 크게 만드는 a를 고릅니다. 최적 가치함수의 벨만 방정식은 V*(s)=R(s)+γ max_a ∑_{s′}P_{sa}(s′)V*(s′)가 됩니다.
⏱ 29:04이 식은 상태 s에서 시작할 때 얻을 수 있는 최고의 총 기대 수익이 즉시 보상 R(s)에, 가능한 모든 행동 가운데 미래 기대 수익을 가장 크게 하는 행동의 할인된 수익을 더한 것이라고 말합니다. 최대화 기호 안에 있는 항이 미래 기대 보상입니다. 방금 논의로 π*(s)를 구하는 방법도 알 수 있습니다. 아직 계산 방법을 배우지는 않았지만, 어떤 방법으로 V*(s)를 알고 있다고 합시다. 제가 최적 가치들을 알려 준 뒤 “로봇이 지금 s에 있는데 어떤 행동을 해야 할까요?”라고 묻는다면 어떻게 답하겠습니까? π*가 최적 정책이 되어야 하므로 π*(s)에 무엇을 넣을지 생각해 보세요.
⏱ 30:317. 최적 가치에서 최적 정책 추출하기

⏱ 30:31V*를 계산했다고 합시다. 로봇이 상태 s에 있다면 어떤 행동을 취하는 것이 가장 좋을까요? 답은 위의 식에 거의 나와 있습니다. 학생이 답합니다. [학생의 발언은 불명확함.] 네, 맞습니다. 여기서 “가장 좋다”는 것은 총수익의 기댓값을 최대화한다는 뜻입니다. 따라서 위 식에서 선택했던 것과 같은, 값을 최대화하는 행동 a를 고르면 됩니다. 즉 π*(s)=argmax_a ∑_{s′}P_{sa}(s′)V*(s′)입니다. γ는 양의 상수이므로 argmax의 결과에 영향을 주지 않으며, 보통 식에서 생략합니다.
⏱ 31:40이것이 MDP의 최적 정책을 찾는 전략입니다. 우선 V*를 계산할 방법을 찾아야 합니다. 지금까지 V*는 지수적 또는 조합적으로 많은 정책 전체에 걸친 최댓값으로 정의했으므로, 정의만으로는 효율적인 계산 방법을 얻은 것이 아닙니다. 하지만 V*를 구할 수만 있으면 여기의 식을 이용해 각 상태에서 argmax를 상당히 효율적으로 계산하고 그 상태의 최적 행동을 알아낼 수 있습니다. 여기 쓴 부분은 지우고 이 식을 사용하겠습니다. 결국 많은 정책을 직접 나열하는 문제를 먼저 가치함수를 구하는 문제로 바꾸려는 것입니다.
⏱ 32:50다소 혼란스러운 표기를 연습할 겸 다음 관계를 보겠습니다. 여기서는 증명하지 않고 주장만 하겠습니다. 모든 상태 s와 모든 정책 π에 대해 V*(s)=V^{π*}(s)≥V^π(s)입니다. 왼쪽은 최적 가치함수이고, 가운데는 특정한 정책의 가치함수인데 그 특정 정책이 바로 π*입니다. 따라서 상태 s의 최적 가치는 그 상태에서 π*를 실행했을 때의 가치와 같고, 다른 어떤 정책 π의 가치보다도 크거나 같습니다. 지금은 증명을 제시하지 않았다는 점과, 최적 가치함수와 특정 정책의 가치함수를 구분하는 이 표기를 이해하면 됩니다.
⏱ 34:19전략은 두 단계입니다. 첫째, V*를 구합니다. 둘째, argmax 식으로 π*를 구합니다. 두 번째 단계는 이미 방법을 알고 있습니다. 그러므로 이제 첫 번째 단계를 위한 알고리즘을 다루겠습니다. V*만 계산하면 모든 상태의 최적 행동을 빠르게 결정할 수 있기 때문입니다. 그 알고리즘이 가치 반복입니다. 먼저 모든 상태의 추정 가치를 0으로 초기화하고, 최적 가치함수 V*에 대한 벨만 방정식으로 추정치를 갱신합니다. 갱신식은 V(s) ← R(s)+γ max_a ∑_{s′}P_{sa}(s′)V(s′)입니다.
⏱ 36:478. 가치 반복의 갱신과 흡수 상태 구현
⏱ 36:47파이썬으로 구현하는 방법을 구체적으로 말하자면, V(1,1), V(1,2) 등에서 V(4,3)까지 각 상태의 값을 저장할 11차원 벡터를 만들면 됩니다. 잠깐, 제가 11개라고 했나요? MDP 상태가 10개 아닌가요? 지금까지 계속 11개라고 했나요? 미안합니다, 10개…… 잠깐, 11개라고요? 네, 여러분 말이 맞습니다. 상태는 11개입니다. 따라서 11차원 벡터를 만들고 모든 성분을 0으로 초기화합니다. 그 뒤 각 상태의 추정 가치를 벨만 방정식에 따라 반복해서 갱신하면 됩니다.
⏱ 38:10이 갱신식은 두 가지 방식으로 해석할 수 있습니다. 경사하강법을 떠올려 보세요. 매개변수 벡터 θ의 갱신 규칙을 쓰고, θ의 모든 성분을 동시에 갱신했습니다. 이런 방식을 동기 갱신(synchronous update)이라고 합니다. 여기서는 기존 값들을 사용해 11개 상태 모두에 대한 식의 오른쪽을 먼저 계산한 다음, 11개 값을 한꺼번에 덮어쓰는 것입니다. 다음 반복에서도 오른쪽 값 11개를 모두 계산한 뒤 전체를 동시에 바꿉니다. 한 번의 갱신에 쓰는 값들이 같은 이전 추정치에서 온다는 뜻입니다.
⏱ 39:03다른 방법은 비동기 갱신(asynchronous update)입니다. 먼저 다른 상태의 값들에 의존하는 V(1,1)을 계산하고 그 성분을 즉시 덮어씁니다. 이어 V(1,2)를 계산해 바꾸는 식으로 하나씩 진행합니다. 따라서 V(4,3)을 계산할 무렵에는 앞서 갱신한 일부 상태의 새 값을 사용하게 됩니다. 가치 반복은 동기 방식이든 비동기 방식이든 작동합니다. 다만 동기 갱신이 벡터화하기 좋고 효율적인 행렬 연산을 사용할 수 있어서 흔히 쓰입니다. 특별히 달리 말하지 않으면, 여기서 가치 반복은 11개 값을 모두 계산한 뒤 한꺼번에 갱신하는 동기 방식을 뜻한다고 생각하면 됩니다.
⏱ 40:31질문이 있었나요? [학생의 질문은 불명확함.] +1이나 −1에 도달하면 세계가 끝나는 흡수 상태, 즉 싱크 상태를 어떻게 표현하느냐는 질문입니다. 이 틀에서는 그 상태에서 다른 모든 상태로 가는 전이 매개변수를 0으로 두는 방식으로 구현할 수 있습니다. 이 방법으로 계산이 됩니다. 다른 방법은 실제 구현에서는 덜 쓰지만 수학적으로는 더 깔끔할 수 있는데, 상태가 11개인 MDP에 열두 번째 상태를 추가하는 것입니다. 그 상태는 항상 자기 자신으로 돌아가며 이후 보상을 전혀 주지 않습니다. 두 방법은 같은 결과를 냅니다. 나가는 전이 항을 0으로 놓는 것이 편리합니다.
⏱ 41:339. 벨만 백업 연산과 가치 반복의 수렴

⏱ 41:33흡수 상태에서는 다른 모든 상태에 대해 P_{sa}(s′)=0으로 둘 수 있습니다. [설명의 일부는 불명확함.] 이 방식으로도 올바른 답을 얻습니다. 이제 표기 하나를 설명하겠습니다. 동기 갱신은 이전 가치함수 추정치로 새 추정치를 계산하는 것으로 볼 수 있습니다. 이전 반복에서 얻은 11차원 가치 벡터가 있고, 알고리즘을 한 번 적용하면 새로운 추정값 집합을 얻는 것입니다. 즉, 이전의 11개 추정값에서 출발해 같은 식으로 새 추정값 11개를 계산하고 벡터를 바꾸는 것입니다. 이 한 단계를 벨만 백업 연산자(Bellman backup operator)라고 부르기도 합니다. V를 11차원 벡터로 두고 V ← B(V)라고 쓰면, B는 이전 벡터에 여기의 갱신식을 적용하는 연산입니다.
⏱ 42:51과제에서 보일 내용 중 하나는 이 과정에 따라 V(s)가 V*(s)로 수렴한다는 것입니다. 벨만 방정식을 반복적으로 적용하면 11개 값으로 이루어진 벡터 V가 최적 가치함수 V*로 수렴합니다. 자세한 내용은 숙제에서, 그리고 강의 노트에서도 조금 더 보게 될 것입니다. 실제로 이 알고리즘은 꽤 빠르게 수렴합니다. 예를 들어 할인율이 0.99라면 매 반복에서 오차가 0.99배로 줄어든다는 것을 보일 수 있습니다. 따라서 V는 최적 가치함수 V*에 기하급수적으로, 다시 말해 지수적으로 빠르게 가까워집니다.
⏱ 44:17할인율이 0.99라면 100번 또는 수백 번 정도 반복했을 때 V가 V*에 매우 가까워질 수 있습니다. 할인율이 0.9라면 열 번이나 수십 번 정도만으로도 꽤 가까워집니다. 그만큼 빠르게 수렴한다는 뜻입니다. 지금까지의 내용을 종합하면, 예제 MDP에 가치 반복을 실행했을 때 여기 보이는 V*를 얻게 됩니다. 가능한 11개 상태 각각에서 출발할 때의 최적 기대 수익을 나타내는 숫자 11개입니다. 추수감사절 전에 저는 여기 표시한 화살표들이 최적 정책이라고도 말했습니다.
⏱ 46:32구체적인 사례로 V*를 이용해 이 상태의 최적 행동을 계산해 보겠습니다. argmax 식에서 서쪽, 즉 왼쪽에 대한 ∑_{s′}P_{sa}(s′)V*(s′)를 구하면 됩니다. 왼쪽으로 이동을 시도하면 확률 0.8로 최적 가치가 0.75인 상태에 도달합니다. 확률 0.1로는 북쪽으로 빗나가 가치가 0.69인 상태에 가고, 확률 0.1로는 남쪽으로 갔다가 벽에 부딪혀 가치가 0.71인 상태에 남습니다. 따라서 기대 미래 수익은 0.8×0.75+0.1×0.69+0.1×0.71=0.740입니다.
⏱ 48:1010. 행동별 기대 가치 비교와 연속 상태 질문

⏱ 48:10반대로 북쪽으로 간다면 비슷하게 가중평균을 계산해 0.8×0.69+0.1×0.75+0.1×0.49=0.676을 얻습니다. 서쪽으로 갈 때의 기대 미래 보상 0.740이 북쪽으로 갈 때보다 상당히 큽니다. 따라서 이 간단한 계산으로 이 상태에서는 왼쪽으로 가는 편이 좋다는 결론을 낼 수 있습니다. 엄밀하게는 북·남·동·서 네 행동을 모두 확인하고, 서쪽으로 갈 때 기대 보상이 가장 높다는 사실을 검증해야 합니다. 그런 과정을 거쳐 여기서는 서쪽이 최선의 행동이라고 결정하는 것입니다.
⏱ 49:01이것이 가치 반복입니다. MDP가 주어지면 이 알고리즘을 구현해 V*를 구하고 π*를 계산할 수 있습니다. 더 다룰 내용이 몇 가지 있지만 넘어가기 전에 질문을 받겠습니다. [학생의 질문은 불명확함.] 상태의 수가 항상 유한한지 묻는 것이지요? 지금까지 논의한 범위에서는 그렇습니다. 수요일에는 이 틀을 일반화하는 방법을 볼 것입니다. 연속 상태 MDP를 다룰 때 흔히 쓰는 방법 중 하나는 상태 공간을 유한한 수의 상태로 이산화하는 것입니다. 한편 연속 상태에 직접 적용할 수 있는 가치 반복의 다른 형태들도 있습니다.
⏱ 50:22MDP를 푸는 또 다른 대표적인 교과서 알고리즘은 정책 반복(policy iteration)입니다. 알고리즘을 써 보겠습니다. 먼저 π를 무작위로 초기화합니다. 가치 반복과 정책 반복의 장단점은 잠시 뒤 비교하겠습니다. 가치 반복에서는 관심의 중심이 V*였습니다. 최적 가치함수를 구하는 데 작업을 집중하고, V*를 얻은 다음 가장 좋은 정책을 정했습니다. 정책 반복에서는 가치함수보다 정책 π에 초점을 맞춥니다. 11개 상태 각각에 대해 무작위 행동 하나를 골라 처음의 무작위 정책을 구성하는 것입니다.
⏱ 52:21그런 다음 두 단계를 반복합니다. 첫 번째 단계는 현재 정책 π의 가치함수를 푸는 것입니다. V^π가 미지수 11개에 대한 선형 방정식 11개로 정해진다는 점을 기억하세요. π를 고정하면 선형대수 풀이기를 사용해 대략 행렬을 역으로 푸는 정도의 계산 비용으로 11개 값을 모두 구할 수 있습니다. 그 풀이기로 방금 무작위로 초기화한 정책의 가치함수를 구하고 V=V^π로 놓습니다. 이 단계는 선형 방정식 풀이기를 이용해 효율적으로 수행할 수 있습니다.
⏱ 53:2811. 정책 평가와 개선을 번갈아 수행하기
⏱ 53:28두 번째 단계에서는 V가 최적 가치함수인 것처럼 간주하고 앞서 사용한 행동 최대화 규칙으로 π(s)를 갱신합니다. 즉 π(s) ← argmax_a ∑_{s′}P_{sa}(s′)V(s′)입니다. 그 뒤 다시 반복합니다. 새 정책이 주어지면 그 정책의 선형 연립방정식을 풀어 새 V^π를 얻고 정책을 다시 개선합니다. 수렴할 때까지 이 두 단계를 번갈아 수행합니다. [학생의 질문은 불명확함.] 네, 맞습니다. 가치 반복은 먼저 V*를 구한 뒤 마지막에 π(s)를 계산한다고 생각하면 됩니다. 정책 반복은 그와 달리 매 반복마다 새 정책을 만듭니다.
⏱ 54:49정책 반복 역시 최적 정책으로 수렴합니다. 장단점을 비교해 보면, 정책 반복은 V^π를 구하기 위해 선형 연립방정식을 풀어야 합니다. 상태가 11개이거나 수백 개 정도로 비교적 작다면 방정식을 풀기가 쉬워서 정책 반복이 상당히 빠르게 작동합니다. 그러나 상태가 1만 개나 100만 개라면 이 단계가 훨씬 느려집니다. 정책 평가를 연립방정식의 직접 풀이로 구현한다면 저는 큰 문제에서 가치 반복을 택하겠습니다. 미지수 100만 개에 방정식 100만 개를 푸는 것은 비쌉니다. 반면 미지수 11개와 식 11개는 아주 작은 시스템입니다.
⏱ 56:08또 다른 차이도 있는데, 실용적인 차이보다는 학술적인 차이에 가깝습니다. 가치 반복의 V는 V*를 향해 수렴하지만 일반적으로 유한 번의 반복으로 정확히 V*가 되지는 않습니다. 선형회귀에 경사하강법을 적용하면 전역 최적점에 계속 더 가까워지지만 정확히 그 점에 도착하지는 않는 것과 비슷합니다. 아주 빠르게 가까워지고, 점근적으로 기하급수적 또는 지수적으로 수렴하지만, 유한한 갱신 뒤에 최적값을 정확히 얻는다는 뜻은 아닙니다. 반대로 정규방정식은 점차 접근하는 대신 곧바로 최적값을 구합니다. 가치 반복도 이런 의미에서 V*에 계속 가까워집니다.
⏱ 57:03실제로는 이 구분이 큰 영향을 주지 않을 수 있습니다. 정책 반복은 유한한 횟수 뒤에 정책이 바뀌지 않게 됩니다. 정책의 가치함수를 계산하고 다시 argmax들을 취했는데 완전히 같은 정책이 나오는 것입니다. 그래서 수렴 시에는 최적 정책과 그 최적 가치를 실제로 얻으며, 계속 가까워지기만 하는 상황과는 다릅니다. 실무에서는 가치 반복이 훨씬 더 많이 쓰이는 것을 봅니다. 상태 공간이 커지면 선형 연립방정식을 푸는 비용이 커지기 때문입니다. 다만 작은 문제라면 정책 반복을 사용할 수도 있고, 그 경우 조금 더 빨리 수렴할 수 있습니다.
⏱ 58:2312. 데이터에서 상태 전이 확률 추정하기
⏱ 58:23마지막으로 모든 것을 종합해 보겠습니다. P_{sa}를 모른다면 어떻게 해야 할까요? 실제 로봇 문제에서는 상태 전이 확률을 모르는 상황이 흔합니다. 단순화한 예제에서는 로봇이 의도한 방향으로 갈 확률을 0.8, 좌우로 빗나갈 확률을 각각 0.1이라고 정했습니다. 하지만 실제 로봇이나 헬리콥터를 만들거나 상대방과 체스를 둘 때는 전이 확률을 미리 모르는 경우가 많습니다. 따라서 많은 MDP 구현에서는 이 확률들을 데이터로부터 추정해야 합니다.
⏱ 59:35강화학습 프로젝트의 전형적인 흐름은 어떤 정책, 예를 들어 무작위 정책을 실행해 로봇이 미로를 돌아다니게 하는 것입니다. 북쪽 행동을 선택한 횟수 가운데 실제 북쪽으로 간 경우는 얼마나 되고, 좌우로 빗나간 경우는 얼마나 되는지 셉니다. 그 통계로 전이 확률을 추정합니다. 자연스러운 식은 P̂_{sa}(s′)=[상태 s에서 행동 a를 취한 뒤 s′에 도달한 횟수]/[상태 s에서 행동 a를 취한 횟수]입니다. 이것이 최대우도 추정량입니다. s에서 a를 시도했던 경우들 가운데 s′로 간 비율을 사용하는 것입니다.
⏱ 1:01:05위의 분자와 분모가 모두 0인 경우에는 흔히 P̂_{sa}(s′)=1/|S|라는 경험적 규칙을 사용합니다. 상태 s에서 행동 a를 한 번도 시도하지 않았으므로 어떤 일이 일어나는지 전혀 모르는 상황입니다. 그래서 다른 어느 상태로든 균등하게 이동한다고 가정하는 것입니다. 상태가 11개인 예에서는 각 상태의 확률을 1/11로 둡니다. 강화학습 알고리즘을 구현할 때 자주 쓰는 처리 방식입니다. 원한다면 라플라스 평활화(Laplace smoothing)를 사용할 수도 있지만, 반드시 그렇게 할 필요는 없습니다.
⏱ 1:01:5313. 전이·보상을 학습하는 강화학습 절차

⏱ 1:01:53이 예에서 라플라스 평활화를 쓰려면 분자에 1을, 분모에 11을 더하면 됩니다. 이렇게 해도 0/0 문제를 피할 수 있습니다. 하지만 나이브 베이즈와 달리 MDP 풀이기는 확률 0에 그다지 민감하지 않습니다. 나이브 베이즈 분류에서는 확률이 0인 항이 있으면 심각한 문제가 될 수 있지만, 가치 반복이나 정책 반복은 추정 확률 몇 개가 정확히 0이라는 이유만으로 터무니없거나 형편없는 결과를 내지는 않습니다. 원한다면 평활화를 써도 되지만 여기서는 흔히 쓰지 않으며, 방금 적은 추정식과 미관측 경우의 처리 방식이 더 일반적입니다.
⏱ 1:03:01모든 것을 결합해 보겠습니다. 제가 로봇을 주고 좋은 정책을 찾는 MDP 풀이기를 구현하라고 한다면 다음과 같이 하면 됩니다. 어떤 정책 π에 따라 행동해 MDP 안에서 경험을 수집합니다. 로봇을 풀어 놓고 그 정책을 한동안 실행하게 하는 것입니다. 여러 상태에서 행동했을 때 어디로 가는지 관찰한 결과로 P_{sa}의 추정치를 갱신합니다. 그런 다음 가치 반복으로 벨만 방정식을 풀어 V를 얻고, 기대 가치를 최대화하는 행동을 고르는 규칙으로 정책을 갱신합니다. 원한다면 이 단계에 가치 반복 대신 정책 반복을 넣어도 됩니다.
⏱ 1:05:28전이 확률을 미리 모르는 실제 로봇이라면 이 과정을 반복합니다. 현재의 전이 확률 추정치로 정책을 구하고, 더 많은 경험을 얻고, 추정치를 갱신한 뒤 새 정책을 찾는 것입니다. 이렇게 반복해서 좋은 정책에 수렴하기를 기대합니다. 내용을 조금 더 풍부하게 설명하자면, 보상함수는 보통 문제 명세의 일부로 주어진다고 생각하지만, 때로는 보상도 모르거나 무작위적일 수 있습니다. 예를 들어 주식 거래 응용에서 보상이 특정한 날의 수익률이라면, 그것이 상태만으로 정해지는 결정적 함수가 아니라 어느 정도 무작위적일 수 있습니다.
⏱ 1:06:39또 로봇이 돌아다니는 곳에 따라 여러 요철을 만날 수 있고, 요철을 지날 때마다 벌점을 주고 싶을 수도 있습니다. 자율주행차라면 울퉁불퉁한 곳이나 포트홀에 부딪힐 때마다 음의 보상을 주는 식입니다. 이런 경우 보상은 환경 또는 상태에 따른 확률적인 함수가 됩니다. 따라서 경험으로 각 상태에서의 보상 기댓값도 추정할 수 있습니다. 그 보상 추정치까지 사용해 같은 절차를 실행하면 수렴에 도움을 줄 수 있습니다. [학생들의 질문은 불명확함.] 좋은 질문입니다. 이제 탐색에 관해 이야기하겠습니다.
⏱ 1:07:4214. 작은 보상에 머무르는 탐욕적 정책의 한계

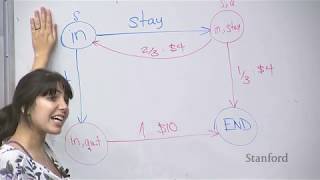
⏱ 1:07:42이 알고리즘은 어떤 문제들에서는 잘 작동하지만, 아직 해결하지 않은 문제가 하나 있습니다. 바로 탐색(exploration)입니다. 강화학습에서는 “탐색과 활용(exploitation)”이라는 말을 자주 듣게 됩니다. 다른 MDP 예를 보겠습니다. 로봇은 여기에서 출발하고, 한쪽에는 +1 보상, 다른 곳에는 +10 보상이 있다고 합시다. 처음 실행했을 때 우연히 +1을 발견했다면 알고리즘은 그쪽으로 가는 것이 좋다고 판단할 수 있습니다. 할인율이 있고 매 단계 연료비 −0.02가 부과되므로, +1을 얻어 세계를 끝내면 이후의 연료 벌점도 더는 내지 않기 때문입니다.
⏱ 1:08:45처음 몇 번의 실행에서 우연히 +1만 찾았다면 이 알고리즘은 국소적으로 탐욕적인 선택을 합니다. 결국 늘 +1로 향하는 좋지 않은 국소 해에 머무를 수 있습니다. 그쪽으로 가는 중에 가끔 무작위로 빗나가 상태 공간의 오른쪽 절반에서 경험을 더 모으고, 그 영역의 전이를 꽤 잘 추정할 수도 있습니다. 그래도 왼쪽 아래에 숨은, 찾기 어려운 +10이라는 보물은 끝내 발견하지 못할 수 있습니다. 이것이 탐색과 활용의 문제입니다. MDP에서 행동할 때 당장 보상을 최대화할 것처럼 보이는 행동만 얼마나 적극적으로 선택해야 하느냐는 질문입니다.
⏱ 1:09:55지금 설명한 알고리즘은 비교적 탐욕적입니다. 현재 가장 그럴듯한 전이 확률과 보상 추정치를 사용해, 현재의 기대 수익 추정치를 최대화하는 정책을 택하고 그대로 실행합니다. 매 단계에서 지금 알고 있는 한 기대 수익을 최대화한다고 믿는 행동을 하는 것입니다. 이 알고리즘이 전혀 하지 않는 것은 처음에는 덜 좋아 보이는 행동을 의도적으로 취하는 탐색입니다. 로봇이 +10을 본 적도 없고 가는 방법도 모른다면, 무슨 일이 생기는지 보려고 그냥 몇 번 왼쪽으로 가 볼 필요가 있을지 모릅니다. 현재 지식으로는 손해처럼 보여도 새 행동을 시도하면 새로운 보물을 발견할 수 있습니다.
⏱ 1:11:0115. 온라인 광고에서도 필요한 탐색과 활용
⏱ 1:11:01이 상충관계는 학술적인 문제만이 아닙니다. 일부 대형 온라인 광고 플랫폼도 같은 문제를 겪습니다. 광고 사업은 수익성이 높지만 다른 문제도 일으키므로 저는 복잡한 감정을 갖고 있습니다. 광고주가 새 광고를 올리면 플랫폼은 누가 그 광고를 가장 잘 클릭할지 모릅니다. 순수한 활용, 즉 exploitation은 특히 광고에서 쓰면 어감이 참 나쁘네요. [웃음.] 하지만 여기서는 사회적인 착취라는 불쾌한 뜻이 아니라 강화학습의 기술적 용어입니다. 순수 활용 정책은 단기 수익을 높이기 위해 각 사용자가 지금 가장 클릭할 것이라고 예상되는 광고만 계속 보여 주는 것입니다.
⏱ 1:12:10반면 탐색 정책은 지금 가장 클릭할 것 같다고 예상되는 광고가 아닌 것도 가끔 보여 줍니다. 나 또는 사용자 집단에게 클릭 가능성이 조금 낮은 광고를 보여 줌으로써 관심사를 더 알게 되고, 나중에 더 관련성 높은 광고를 찾는 능력이 좋아질 수 있습니다. 예를 들어 제가 알기로는 화성 착륙선 광고는 없겠지만, 플랫폼이 제가 화성 착륙선에 관심이 많다는 사실을 모른다고 합시다. 그런 광고가 있다고 가정하고 저에게 보여 주었는데 제가 클릭하면, 플랫폼은 저에게 그 광고를 보여 주는 것이 좋다는 것을 배우게 됩니다. 아직 알아내지 못한 여러분의 다른 관심사에도 같은 원리가 적용됩니다.
⏱ 1:12:58이것은 실제로 존재하는 문제입니다. 일부 대형 광고 플랫폼은 탐색과 활용을 명시적으로 고려합니다. 가장 클릭 가능성이 높지는 않은 광고도 일부 보여 주어 정보를 수집하고, 미래 보상을 더 잘 알아낼 수 있는 위치에 서려는 것입니다. 이렇게 모은 정보는 광고를 여러분뿐 아니라 여러분과 비슷한 다른 사용자들에게도 더 잘 연결하도록 돕습니다. 우리의 강화학습 알고리즘도 활용과 함께 탐색을 하도록 만들려면 흔히 다음처럼 수정합니다. 확률 0.9로 정책 π를 따르고, 확률 0.1로 무작위 행동을 취하게 하는 것입니다.
⏱ 1:14:1116. 엡실론 탐욕 탐색과 수렴

⏱ 1:14:11이 탐색 정책을 엡실론 탐욕(ε-greedy) 정책이라고 합니다. 매 시간 단계에서 치우친 동전을 던진다고 생각하세요. 확률 90%로 현재 가장 좋다고 생각하는 정책을 실행하고, 확률 10%로는 무작위 행동을 고릅니다. 이렇게 하면 로봇이 가끔 우연히 +10이라는 보물을 발견할 가능성이 높아집니다. 그곳에 관련된 상태 전이 확률을 배우고, 결국 상태 공간을 더 철저하게 탐색하게 됩니다. 현재 정책만 계속 따르는 행동 과정에 무작위 시도를 섞는 방식입니다.
⏱ 1:14:47저는 “엡실론 탐욕”이라는 이름이 조금 오해를 부른다고 생각합니다. 예를 들어 ε=0.1은 탐욕적인 행동 대신 무작위 행동을 취할 확률입니다. 이름만 보면 시간의 0.1만큼 탐욕적으로 행동하는 것처럼 들리지만, 실제로는 시간의 0.1만큼 무작위로 행동합니다. 차라리 “1−ε 탐욕”이라고 하는 편이 더 맞을지도 모르겠습니다. 예전부터 조금 이상한 이름이라고 생각했지만 사람들이 이 용어를 그렇게 사용합니다. ε는 알고리즘의 매개변수, 즉 하이퍼파라미터이며, 확률 ε로 현재 최선이라고 생각하는 정책 대신 무작위 행동을 합니다.
⏱ 1:15:41엡실론 탐욕 탐색을 포함해 이 알고리즘을 구현하면 이산 상태 MDP의 최적 정책으로 수렴합니다. 때로는 오래 걸릴 수 있습니다. 무작위로 움직여 +10이라는 보물을 우연히 찾기까지 자체적으로 긴 시간이 걸릴 수 있기 때문입니다. 그래도 탐색 정책을 포함한 알고리즘은 최적 정책으로 수렴한다는 설명입니다. 질문이 무엇인가요? [학생의 질문은 불명확함.] ε를 계속 일정하게 둘지, 동적으로 바꿀지 묻는 것이군요. 탐색에는 여러 경험적 방법이 있습니다. 합리적인 방법 하나는 큰 ε로 시작한 뒤 점차 줄여 가는 것입니다.
⏱ 1:16:4117. 볼츠만 탐색과 내재적 동기
⏱ 1:16:41또 다른 흔한 방법은 볼츠만 탐색(Boltzmann exploration)이며, 관심이 있으면 찾아볼 수 있습니다. 북쪽으로 가는 가치가 10이고 남쪽으로 가는 가치가 1이라면 차이가 매우 크므로 더 큰 보상을 주는 행동에 강하게 치우치도록 해야 합니다. 가치에 척도 인수를 적용한 지수함수, 즉 e의 거듭제곱을 이용해 확률을 정할 수 있습니다. 10% 확률로 행동을 완전히 무작위로 고르는 대신, 높은 가치의 행동을 강하게 선호하되 낮은 가치의 행동에도 어느 정도 확률을 주는 것입니다. 구체적인 확률은 가치들의 차이에 따라 달라집니다.
⏱ 1:17:28이런 종류의 MDP에서는 엡실론 탐욕 방식이 가장 자주 쓰이는 것 같습니다. 볼츠만 탐색은 또 다른 선택지라서 함께 설명했습니다. 마치기 전에 질문 두 개만 더 받겠습니다. [학생의 질문은 불명확함.] 한 번도 본 적 없는 상태에 도달했을 때 보상을 줄 수 있느냐고요? 네, 내재적 강화학습(intrinsic reinforcement learning)이라는 흥미로운 연구 분야가 있습니다. [그 기원을 설명하는 대목은 불명확하며 자막에는 “search indexing”으로 기록되어 있음.] 내재적 동기(intrinsic motivation)를 검색하면 관련 논문을 찾을 수 있습니다. 딥마인드나 다른 연구 그룹에서도 최근 후속 연구를 했던 것으로 기억합니다. 세계에 관해 새로운 것을 발견하는 강화학습 알고리즘에 보상을 주는 생각입니다.
⏱ 1:18:13마지막 질문입니다. “정책 π에 따라 행동을 몇 번 해야 하나요?” 다시 말해 주겠어요? “π를 갱신하기 전에 π에 따라 행동을 몇 번 해야 하나요?” 알겠습니다. 정책을 얼마나 자주 갱신해야 하느냐는 질문이군요. 가능한 한 자주 해도 나쁠 것은 없습니다. 다만 실제 로봇을 사용하는 경우에는 현실적인 제약이 있을 수 있습니다. 예를 들어 헬리콥터를 날릴 때는 낮에 현장에 나가 데이터를 많이 수집하고, 저녁에 연구실로 돌아와 알고리즘을 다시 실행하는 식으로 작업합니다.
⏱ 1:18:51하지만 계속 갱신하는 데 아무런 제약이 없다면 가능한 한 자주 실행해도 성능에 해가 되지 않습니다. 이것으로 MDP의 기초를 마치겠습니다. 수요일에는 지금까지의 내용을 연속 상태 MDP로 일반화하는 방법을 이어서 다루겠습니다. 오늘은 여기서 마치죠. 수요일에 봅시다.